完成日期:2026年10月29日。软件:本机 Stata/SE 15.1,脚本使用 version 15.0。数据截止年份由文件内容确定,为2014年。
一、研究问题与主要结论
本次工作包括两个问题:解释题目图片中的误差方差估计为何使用分母 n − k − 1,以及将所给 RESSET 财务指标 ROA、ROE 与两份 CSMAR 治理综合信息文件整理、合并。题目原图保留在工作目录。

理论结论: 在含截距、设计矩阵满列秩的多元回归中,估计 k 个斜率及一个截距会对残差施加 k + 1 个独立线性约束。因此,残差自由度为 n − k − 1。在条件均值为零、同方差且误差间不相关的条件下,SSE 除以该自由度是误差方差的无偏估计。
数据结论: 财务文件共有 34,897 条记录,覆盖1990—2014年;治理文件追加后共有 27,090 条记录,覆盖1999—2014年。按“证券代码文本+报告年份”一对一外连接,得到 39,416 条公司年度记录,其中 22,571 条两库匹配,匹配且 ROA、ROE 均非缺失的记录为 22,122 条。
本报告的“所有年份”指所给文件中存在的全部年份。本次直接读取离线导出文件,没有重新登录数据库下载。2014年财务数据覆盖明显不足,文件中还存在非标准代码和非通常沪深A股代码前缀,不能将这些导出记录称为全市场全部上市公司的完整历史。
二、为什么分母要减去 k + 1
2.1 先区分随机误差和估计残差
设总体回归模型为:
其中,uᵢ 是不可直接观测的随机误差,eᵢ 是估计模型后得到的残差。n 是实际进入回归的完整观测数,k 是不含截距的解释变量个数。题目中的 σ̂² 估计的是随机误差方差,计算时使用可观测的残差平方和。
2.2 从正规方程理解自由度
OLS 用同一批观测拟合 k + 1 个参数,使残差平方和尽可能小。一阶条件为:
当设计矩阵满列秩时,这 k + 1 个条件是独立的线性约束。虽然残差向量有 n 个元素,它只能在 n − k − 1 维空间中变化。这就是残差自由度。这里指线性自由度,并不意味着任取 n − k − 1 个原始残差就一定在概率意义上相互独立。
只有截距时,估计的是样本均值,分母退化为 n − 1,与样本方差公式相同。简单线性回归估计截距和一个斜率,分母为 n − 2。
2.3 无偏性的矩阵推导
令 p = k + 1,X 包含截距列,且 rank(X) = p < n。假设条件均值 E(u∣X) = 0,条件方差矩阵 Var(u∣X) = σ²Iₙ。后一个条件同时要求同方差与不同观测误差不相关。
定义投影矩阵 H 与残差生成矩阵 M:
利用 M 的对称性、幂等性与迹的性质:
因此:
如果直接除以 n,则 E(SSE/n∣X) = [(n − k − 1)/n]σ²,存在向下偏误。自由度调整补偿了利用样本拟合参数所造成的样本内残差平方和下降。
例如 n = 100、k = 3、SSE = 192,残差自由度为96,无偏方差估计为192/96 = 2;直接除以100只得到1.92。
2.4 公式的适用边界
- 一般公式是
n − rank(X)。无截距、完全共线性、虚拟变量和交互项等情况,应按实际独立参数数目计算。 - 正态性不是上述无偏性的必要条件。正态性用于进一步推导精确的卡方、t 和 F 分布。
- 若存在异方差或相关误差,记 Var(u∣X) = Ω,则 E(SSE∣X) = tr(MΩ),通常不能再写成
(n − k − 1)σ²。 - 自由度调整本身不能解决异方差、内生性或模型遗漏问题。采用企业聚类标准误时,Stata 返回的推断自由度可能以聚类数为基础,不能直接替代本题普通 OLS 的残差自由度。
三、数据来源与变量口径
| 输入文件 | 工作表 | 数据行数(不含说明行) | 实际报告年份 |
|---|---|---|---|
| RESSET财务文件 | FININDRATIO_OLD | 34,897 | 1990—2014 |
| CSMAR治理文件1999—2012 | CG_Ybasic | 21,902 | 1999—2012 |
| CSMAR治理文件2013—2014 | CG_Ybasic | 5,188 | 2013—2014 |
RESSET 文件共10列,第1行为中文标题;全部记录的 Reporttype 为 Q4,截止日期均为12月31日,Lstflg 全为 A,B/H 股票代码列全空。不同证券代码为3,633个。源文件中的“最新公司全称”保留为 Lcomnm,不将其视为逐年历史名称。
CSMAR 两份文件均为33列。第1行为英文字段名,第2行为中文含义,第3行为单位,第4行起才是数据。两份文件追加后包含2,737个不同证券代码。本次保留全部原始治理字段,而非仅保留示例回归使用的董事人数。
| 分析字段 | 来源字段 | 处理与含义 |
|---|---|---|
stkcd |
RESSET A_Stkcd;CSMAR Stkcd |
作为文本,保留前导零,仅去除首尾空格;通常为六位 |
year |
RESSET Enddt;CSMAR Reptdt |
使用报告截止年份,不使用公告年份 |
ROA |
资产净利率(%)_ROA | 保留原始数值和缺失值 |
ROE |
净资产收益率(摊薄)(%)_ROE | 保留摊薄口径的原始数值和缺失值 |
Y1101a |
CSMAR 董事人数 | 原始数值字段,示例中构造 board_size |
Y1101b |
CSMAR 独立董事人数 | 与董事人数之比构成 independent_share |
_merge |
Stata merge 生成 |
1:仅财务;2:仅治理;3:两库匹配 |
complete_roa_roe |
派生标记 | 两库匹配且ROA、ROE均非缺失时为1 |
code_format_exception |
派生标记 | 原始证券代码非六位时为1 |
完整字段含义和单位见 变量字典。resset_excel_row、csmar_source 和 csmar_excel_row 可追溯原始工作簿与行号。
ROA、ROE 单位处理: 原列标题写有“(%)”,但 Excel 单元格格式为 General,未提供指标公式或完整数据库数据字典。仅凭标题、格式和数值分布,不能独立确认导出数值究竟采用百分数尺度还是比例小数尺度。本次不乘100、不除100,所有统计均以“原始数值尺度”报告,不将0.0498擅自解释为0.0498%或4.98%。
四、Stata 数据整理与合并方法
- 从RESSET工作表第2行读取数值,保存所有既有年份。验证Q4、12月31日及公司年度键唯一性,保留ROA、ROE原值。
- 分别导入两份CSMAR表,读取中文含义与单位后去掉两行说明;将人数、持股量、薪酬等字段转换为数值。未使用
destring, force,防止无提示地把异常文本变成缺失。 - 使用
append将1999—2012和2013—2014治理数据纵向拼接,验证isid stkcd year。 - 以财务数据为master、治理数据为using,执行
merge 1:1 stkcd year。保留三种合并状态,并核验匹配记录的完整截止日期相等。 - 保存完整外连接数据集,另存匹配子集;在汇总表中分别报告源数据缺失与对方来源未出现,不用零替代缺失。
核心合并代码与完整脚本中的实现一致:
use "resset_financial_all_years.dta", clear
isid stkcd year
merge 1:1 stkcd year using "csmar_governance_1999_2014.dta"
assert Enddt == csmar_date if _merge == 3
isid stkcd year
这里 append 增加治理表的年份记录,merge 按同一公司、同一报告年份横向增加变量。未使用 merge m:m,也未通过强制删除重复键来让合并继续;两端原始公司年度键本身均唯一。
代码例外: RESSET 的Excel第14580、14581行,吉林通海高科技股份有限公司1998、1999年的股票代码原值均为文本 0991。CSMAR 中既没有 0991,也没有 000991。本次保留 0991 并标记,未推测补成另一证券代码,两条均保留在仅财务记录中。
五、合并结果与年度覆盖
| 状态 | 条数 | 解释 |
|---|---|---|
_merge = 1 |
12,326 | 财务表存在,对应公司年度不在治理表 |
_merge = 2 |
4,519 | 治理表存在,对应公司年度不在财务表 |
_merge = 3 |
22,571 | 同一证券代码、同一报告年份两库均存在 |
| 完整外连接 | 39,416 | 三类记录合计 |
| 匹配且双指标完整 | 22,122 | 是匹配记录的子集,不与前三类重复相加 |
核对关系为:34,897 + 27,090 − 22,571 = 39,416。匹配率以财务记录为分母为 64.68%,以治理记录为分母为 83.32%。不同分母回答不同覆盖问题,不应混用。
仅财务的12,326条中,4,279条来自1990—1998年,早于治理文件起始年份;其余8,047条处于1999—2014年。仅治理的4,519条说明对应财务键未在所给文件中出现,不能据此判断公司当年没有财务报告。
两库匹配子集覆盖1999—2014年,共2,376个不同证券代码。该集合是非平衡公司年度面板,不能假定每家公司在每年都有完整记录。原始文件未提供足够的证券类别、历史上市状态及跨代码公司映射资料,本次未按公司名称或代码前缀强行归并实体。
5.1 全部年份的覆盖表
| 报告年 | 财务记录 | 治理记录 | 两库匹配 | 双指标完整 | 匹配/财务 | 匹配/治理 |
|---|---|---|---|---|---|---|
| 1990 | 5 | 0 | 0 | 0 | 0.00% | — |
| 1991 | 5 | 0 | 0 | 0 | 0.00% | — |
| 1992 | 36 | 0 | 0 | 0 | 0.00% | — |
| 1993 | 277 | 0 | 0 | 0 | 0.00% | — |
| 1994 | 511 | 0 | 0 | 0 | 0.00% | — |
| 1995 | 727 | 0 | 0 | 0 | 0.00% | — |
| 1996 | 813 | 0 | 0 | 0 | 0.00% | — |
| 1997 | 918 | 0 | 0 | 0 | 0.00% | — |
| 1998 | 987 | 0 | 0 | 0 | 0.00% | — |
| 1999 | 1,088 | 949 | 782 | 776 | 71.88% | 82.40% |
| 2000 | 1,161 | 1,108 | 924 | 918 | 79.59% | 83.39% |
| 2001 | 1,258 | 1,163 | 977 | 969 | 77.66% | 84.01% |
| 2002 | 1,270 | 1,229 | 1,045 | 1,032 | 82.28% | 85.03% |
| 2003 | 1,354 | 1,288 | 1,107 | 1,090 | 81.76% | 85.95% |
| 2004 | 1,470 | 1,378 | 1,204 | 1,177 | 81.90% | 87.37% |
| 2005 | 1,522 | 1,375 | 1,217 | 1,169 | 79.96% | 88.51% |
| 2006 | 1,690 | 1,456 | 1,292 | 1,235 | 76.45% | 88.74% |
| 2007 | 2,051 | 1,572 | 1,396 | 1,343 | 68.06% | 88.80% |
| 2008 | 2,292 | 1,626 | 1,447 | 1,401 | 63.13% | 88.99% |
| 2009 | 2,441 | 1,774 | 1,593 | 1,539 | 65.26% | 89.80% |
| 2010 | 2,580 | 2,129 | 1,941 | 1,896 | 75.23% | 91.17% |
| 2011 | 3,209 | 2,363 | 2,171 | 2,135 | 67.65% | 91.87% |
| 2012 | 3,554 | 2,492 | 2,297 | 2,276 | 64.63% | 92.17% |
| 2013 | 2,841 | 2,536 | 2,342 | 2,338 | 82.44% | 92.35% |
| 2014 | 837 | 2,652 | 836 | 828 | 99.88% | 31.52% |
“双指标完整”指该年两库匹配且ROA、ROE均非缺失;“—”表示治理文件该年没有记录,分母为零。完整审计表还包括各类未匹配及财务源内缺失数,见 逐年合并统计。
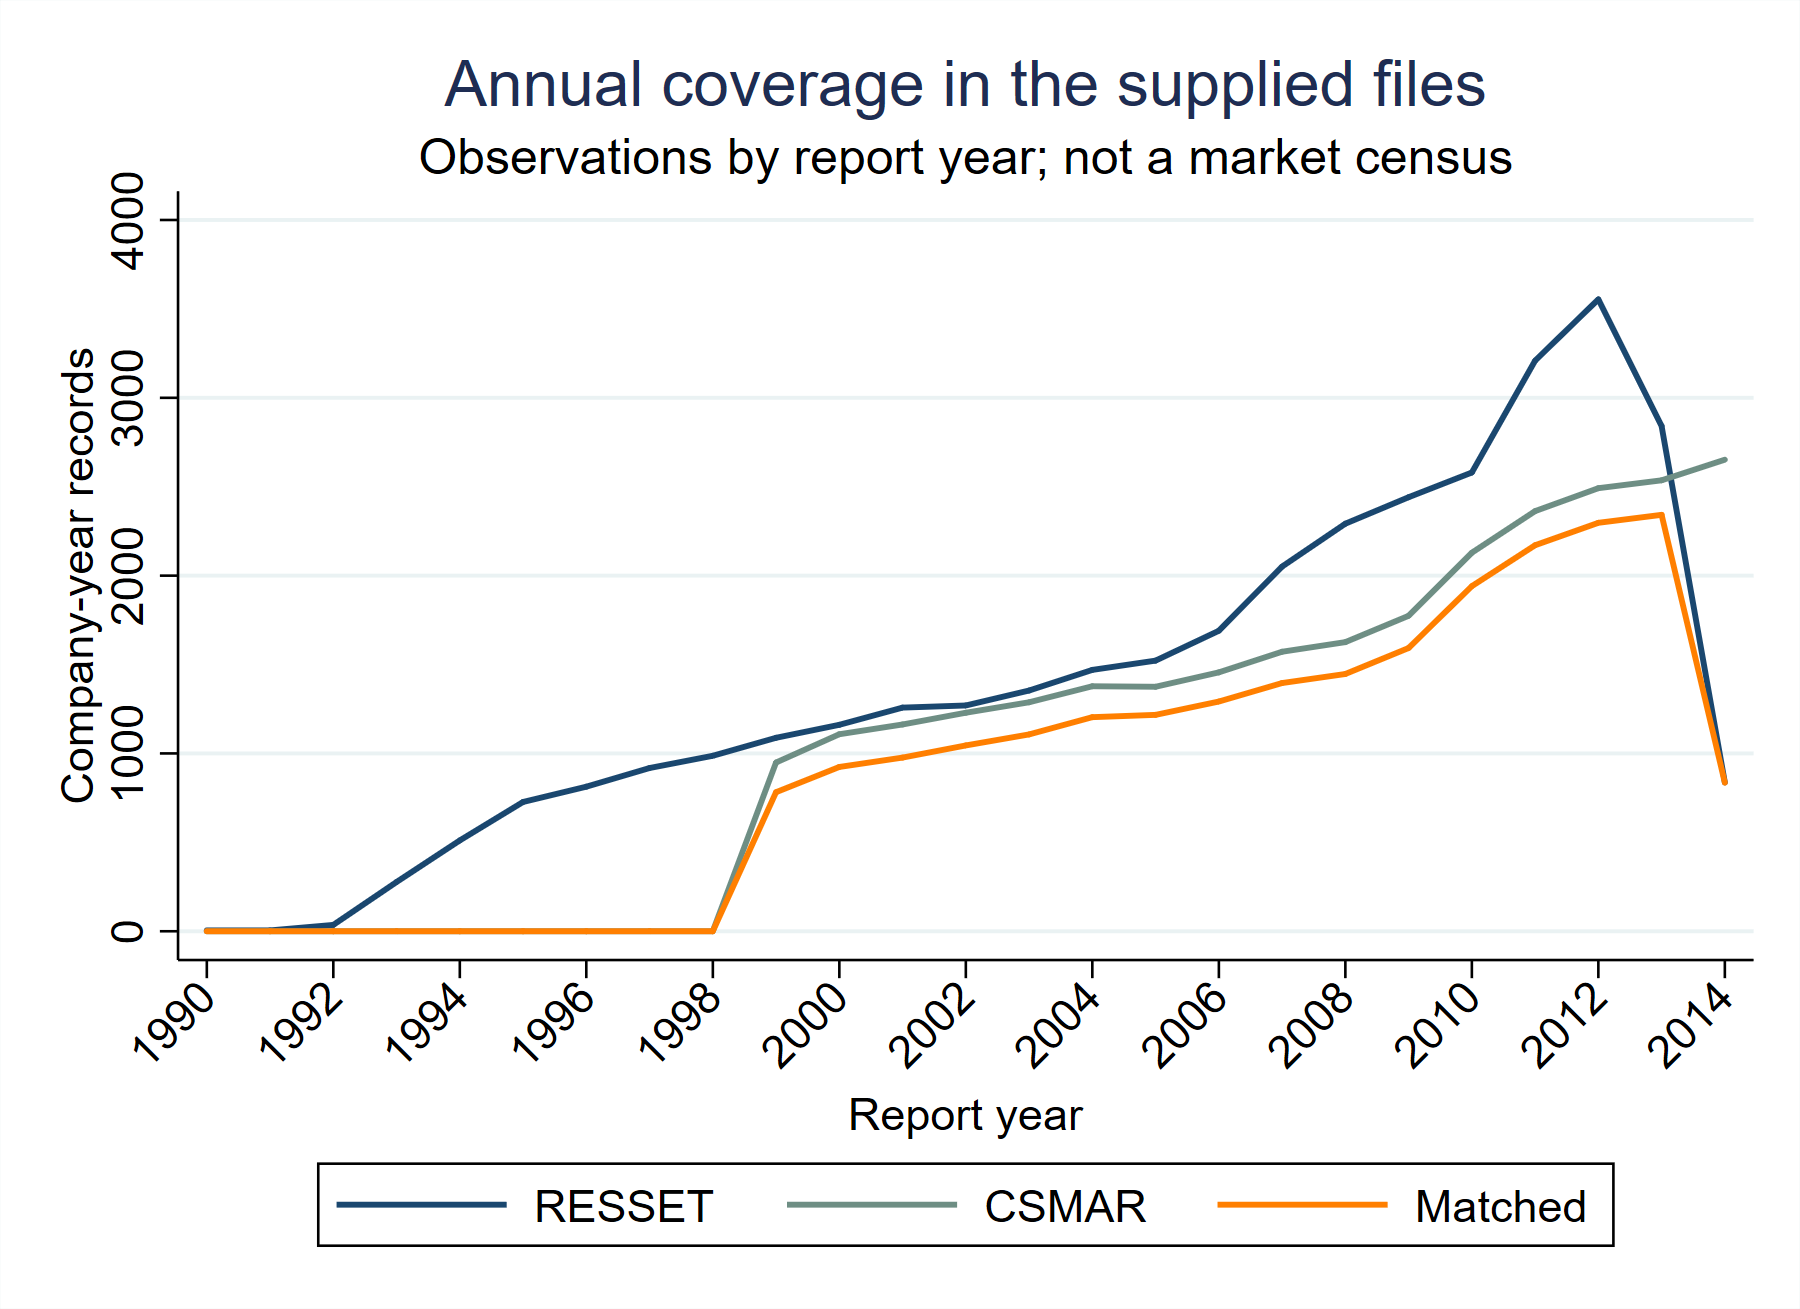
图中 RESSET 表示财务文件记录数,CSMAR 表示治理文件记录数,Matched 表示两库匹配数。该图描述文件覆盖,不能解释为市场公司数量或企业退出趋势。
5.2 2014年为何特别需要注意
2014年财务记录仅837条,治理记录为2,652条,匹配836条。对财务表计算的匹配率为99.88%,但对治理表计算仅为31.52%。较高的前一个比例不能证明2014年财务数据覆盖完整。该年财务文件仅出现000、001、002和600前缀;2013年有2,841条财务记录,2014年的明显减少应首先视为导出覆盖问题,不能直接推断真实经济变化。
六、缺失值、极值与描述统计
全部财务记录中,ROA缺失69条、ROE缺失726条。匹配后,ROA无缺失,ROE仍缺失449条,故匹配与“双指标完整”是两个不同筛选条件。完整外连接中仅治理记录的ROA/ROE为空属于来源缺失,不应与财务表内部缺失混为一谈。
以下数值均使用原始尺度,未进行百分数换算。各变量按自身非缺失观测计算;“匹配且双指标完整”使用共同的22,122条记录。
| 样本 | 变量 | 有效数 | 缺失数 | 均值 | 中位数 | 标准差 | 最小值 | 最大值 |
|---|---|---|---|---|---|---|---|---|
| 全部财务 | ROA | 34,828 | 69 | -0.00162996 | 0.0498 | 10.471 | -1,950.73 | 64.7546 |
| 全部财务 | ROE | 34,171 | 726 | 35.2343 | 0.0958 | 6,512.09 | -1,950.73 | 1.20378e+06 |
| 两库匹配 | ROA | 22,571 | 0 | 0.0360606 | 0.0349 | 0.639555 | -64.8192 | 64.7546 |
| 两库匹配 | ROE | 22,122 | 449 | 0.019237 | 0.0691 | 3.06854 | -188.392 | 159.903 |
| 匹配且双指标完整 | ROA | 22,122 | 0 | 0.0403534 | 0.0355 | 0.106527 | -1.1943 | 7.1963 |
| 匹配且双指标完整 | ROE | 22,122 | 0 | 0.019237 | 0.0691 | 3.06854 | -188.392 | 159.903 |
表中数字为便于阅读而四舍五入;完整精度及P1、P25、P75、P99见 描述统计文件。分位点采用Stata summarize, detail 的定义,可能与采用线性插值的其他软件不同。
源文件含明显极端观测,例如证券代码400033在2012年的ROA为−1,950.7321,代码430082在2011年的ROE为1,203,783.875。全部财务ROE均值约35.2343,而中位数为0.0958,说明均值受尾部值显著影响。匹配ROA的中位数为0.0349,匹配ROE的中位数为0.0691;这些只是导出样本的分布描述,不构成总体盈利水平的代表性估计。
本次没有缩尾、截尾、删除零值或替换异常值,因为题目要求提取与合并原始指标,且没有提供修订依据。极值记录见 原始极值清单。后续实证分析若需要异常值处理,应先核验原始财务报表和指标定义,并单独报告处理规则及敏感性结果。
七、用真实数据验证自由度公式
为将第一题与Stata输出对应,选取2013年两库匹配的横截面,使用ROA作为因变量、董事人数与独立董事比例作为两个解释变量。董事人数须为正,独董比例须在0到1之间。该年2,342条匹配记录全部满足条件,无额外剔除。
使用默认普通OLS,仅验证残差自由度与MSE的计算,不将该模型作为治理影响盈利能力的因果识别模型,也不据此断言其误差满足同方差假设。
regress ROA board_size independent_share if matched & year == 2013 & valid_board
display e(N)
display e(df_r)
display e(rss)/e(df_r)
display e(rmse)^2
| 项目 | Stata 实际结果 |
|---|---|
| 实际估计样本 n | 2,342 |
| 斜率个数 k | 2 |
| 包括截距的参数个数 | 3 |
| 残差自由度 n − k − 1 | 2,339 |
| SSE = e(rss) | 65.691748161464 |
| SSE / (n − k − 1) | 0.028085398957 |
| e(rmse)² | 0.028085398957 |
| SSE / n | 0.028049422785 |
因此该例恰好满足:
脚本同时用预测残差重新计算SSE,结果与 e(rss) 一致。残差之和为3.718e-15,董事人数与残差乘积之和为-3.256e-13,独董比例与残差乘积之和为-1.215e-15,均在浮点计算误差范围内接近零,验证了相应正规方程约束。
e(rmse) 是误差标准差的估计,其平方才是本题中的误差方差估计。回归的完整数值输出见 Stata运行日志,保存的估计结果为 df_example_ols.ster,逐项验证数值为 df_example_metrics.csv。
八、复现步骤与交付文件
在Stata命令窗口运行:
do "C:/Users/cattom/Documents/econometrics/Week8/week8_analysis.do"
脚本直接读取原始Excel,完成整理、合并、审计、描述统计、图表和OLS示例。无需安装额外Stata命令。重复运行会替换本次生成的同名输出,原始 data 目录不被修改。若移动目录,只需修改do-file开头的 cd 行。
也可从PowerShell调用指定Stata程序:
Start-Process -FilePath 'D:\Stata15\StataSE-64.exe' `
  -ArgumentList @('/e','do','C:\Users\cattom\Documents\econometrics\Week8\week8_analysis.do') `
  -WorkingDirectory 'C:\Users\cattom\Documents\econometrics\Week8' `
  -WindowStyle Hidden -Wait
批处理自动产生 week8_analysis.log,研究日志为 week8_stata.log。成功结束标识为 WEEK8_ANALYSIS_COMPLETED_SUCCESSFULLY。
| 文件 | 用途 |
|---|---|
| Week8_研究报告.md | 研究过程、推导与结论 |
| Week8_研究报告.html | 可离线打开、带导航和打印样式的HTML5页面 |
| financial_governance_all_years.dta | 主交付数据,39,416条,保留全部年份与未匹配记录 |
| financial_governance_all_years.csv | 同一主数据的UTF-8通用交换版本 |
| financial_governance_matched.dta | 两库匹配数据,22,571条,保留ROE缺失记录 |
| resset_financial_all_years.dta | 整理后的全部34,897条财务记录 |
| csmar_governance_1999_2014.dta | 追加后的27,090条治理记录 |
| week8_analysis.do;week8_stata.log | 可复现Stata脚本与完整研究运行日志 |
| merge_by_year.csv;processing_audit.csv | 年度覆盖及处理过程计数 |
| unmatched_records.csv;source_extremes.csv | 未匹配记录与原始极值清单 |
| variable_dictionary.csv | 字段、中文含义、单位和来源 |
| descriptive_statistics.csv | 各样本的有效数、缺失与分布统计 |
| annual_coverage.png;annual_coverage.gph | Stata生成的年度覆盖图与可编辑图形 |
| df_example_ols.ster;df_example_sample.dta | OLS示例估计结果、样本与残差 |
| df_example_metrics.csv | 残差自由度、SSE、MSE等核验值 |
| validation_results.json | 独立复核记录 |
优先使用DTA以保留证券代码字符串、日期、变量标签和来源标记。CSV导入其他软件时应把 stkcd 作为文本读取,避免丢失前导零;CSMAR备注含换行,须用标准CSV解析器读取,不能按文本行数统计观测。
只需要同时拥有财务与治理资料时,可从主数据 keep if _merge == 3;同时要求两个财务指标非缺失时,再加 keep if complete_roa_roe == 1。这两个筛选产生22,571和22,122两个不同样本,不应混称。
Stata 的键唯一性、报告日期一致性及残差自由度断言均已通过。独立核验共170项检查全部通过,其中原始Excel与整理、合并DTA比较了2,485,880个源单元格;数值、缺失值和中文文本均与来源一致,最长3,627字符的备注完整保留。主CSV的55列与DTA逐行一致,12项回归指标在CSV和DTA中也一致。CSV导出时对非日期数值使用完整双精度格式,避免默认显示格式造成大额数值四舍五入。源文件SHA-256及详细检查结果见 validation_results.json。
报告由 build_report.py 读取实际Stata汇总结果生成,build_html.py 将Markdown渲染成离线HTML;这些辅助脚本不参与替代Stata的数据合并与估计。若数据更换,先重跑Stata,再运行独立核验和两份报告构建脚本。
九、结论与资料依据
自由度调整的核心是:样本被用于估计参数后,残差可自由变化的维数随之减少。在本题的经典条件下,SSE的期望为 (n − k − 1)σ²,所以应除以残差自由度。2013年示例回归的残差自由度为2,339,SSE除以该值与Stata的Root MSE平方一致。
数据任务已形成保留全部现有年份的可追溯主数据及匹配子集。主要研究限制来自源文件覆盖、ROA/ROE经济尺度尚未获得数据字典确认,以及极值和缺失。现有结果支持描述给定文件的覆盖与数值分布,尚不足以作全市场推断或公司治理的因果结论。
资料依据包括:用户提供的题目图片与三份原始Excel;原始工作簿字段行和单位行;本机Stata 15官方帮助文档 D:/Stata15/ado/base/r/regress.sthlp(Stored results 中对 e(N)、e(df_m)、e(rss)、e(df_r)、e(rmse) 的定义);本机 help merge 对1:1合并及 _merge 状态的说明;以及本次实际运行的Stata日志。理论部分由正规方程和投影矩阵性质逐步推导。本次未成功取得在线手册正文,故不引用未经核验的网页页码或数据库指标公式。